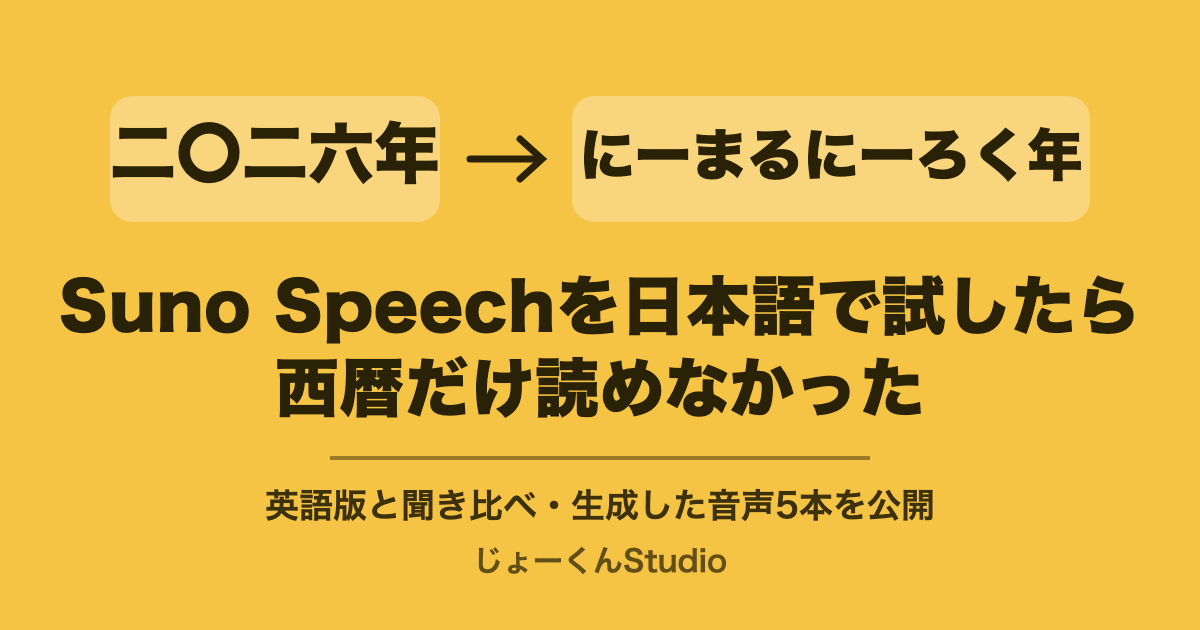
日本語でも喋ります。ただし西暦が読めません。途中で訛りが変わって、外国人が話す日本語のようになる瞬間もあります。ベータ版、つまりお試し段階の機能なので、ここから良くなる前提で見ています。
Suno Speechは2026年10月1日に出たばかりの機能です。歌ではなく、しゃべり声を作ります。公式は声とBGMを一緒に生成する最初のモデルだと説明していて、台本と口調を入れると、ナレーションに音楽が乗った状態で1本の音声が返ってきます。
条件を揃えるために、口調の指示だけ英語で固定した
同じ内容の台本を英語版と日本語版で用意しました。モードはアドバンスド、ボーカル性別は女性、バリエーションは標準。この設定は最後まで変えていません。あとで口調だけ差し替えた1本を別に作っていますが、それは後半で触れます。
口調を書く欄は、比べるための3本で同じ英文に固定しました。入れたのはこれです。
Calm and cinematic narration. Slow, deliberate pace. Mysterious and warm atmosphere, like a story told at night. Steady tone throughout.ここを日本語で書いてしまうと、崩れたときに台本が日本語だったせいなのか指示が日本語だったせいなのか切り分けられなくなります。
台本の中身は、自分の作品シリーズ「表裏一体」の世界観を語るものにしました。エリオ(男・太陽・青い炎)とセリオ(女・月・水)の紹介と、NEON3部作の曲名、締めは「表裏一体。二人でひとつの光になる。」
日本語版にはわざと罠を入れています。漢字の「表裏一体」、漢数字の「二〇二六年」、カタカナの造語(キツネネオン・オボロタイド・カグラライジング)、それに長音と促音(揺るぎなく・まっすぐ・ありのまま)。日本語のナレーションが転ぶのはだいたいこの4種類だと踏んでいました。
英語版の良し悪しは書けない。私は英語が喋れないので
68.8秒。先に断っておくと、英語の発音が自然かどうかは私には判断できません。 喋れないので、ネイティブが聞いて違和感があるかどうかは分かりません。ここで良い悪いを言っても意味がない。
そのうえで、英語が分からなくても分かることが3つありました。
訛りが途中で変わる場面はありません。BGMは語りに合っています。そして曲名の切れ目を1か所まちがえています。
台本には「Kitsune Neon. Oboro Tide. Kagura Rising.」と3つ並べて書きました。返ってきた読みは「キツネ」「ネオンオボロタイド」「カグラライジング」です。Kitsune と Neon のあいだで切って、余った Neon を次の曲名の頭にくっつけている。ピリオドを無視しています。造語なのでどこが切れ目か判断できなかったのだと思います。
ここは英語力と関係なく、聞けば誰でも分かります。
「表裏一体」は読めて、「二〇二六年」が読めなかった
83.12秒。同じ内容なのに英語より14秒長い。日本語は英語の約1.2倍の尺になると見ておけば、動画の尺を決めるときに使えます。
漢字は読めました。「表裏一体」はひょうりいったい、と正しく発音しています。エリオもセリオも読みはブレません。長音と促音もつぶれていません。
そしてカタカナの造語は、英語版で割れた曲名が日本語版では3つとも正しく区切られていました。キツネネオン、オボロタイド、カグラライジング。同じ造語なのに、カタカナで書いたほうが切れ目を間違えない。
落ちたのは西暦です。漢数字で「二〇二六年」と書いたら、「にーまるにーろく年」と読もうとしていました。一文字ずつ数字として処理したのだと思います。ただ、その「にーまるにーろく」自体もはっきりとは発音できていません。読み方を間違えたうえに、その間違った読みも言いきれていない状態です。
ならば算用数字で「2026年」と書けばいいかというと、こちらも外しました。「にじゅうにじゅうろく年」です。英語の「トゥエンティ・トゥエンティシックス」と同じ区切り方を、そのまま日本語の数字に当てはめている。英語版が西暦を正しく読んでいたので、同じ読み方のクセが日本語にも出たのだと思います。
漢数字も算用数字も外すので、西暦を確実に読ませる書き方はいまのところ分かりません。ひらがなで「にせんにじゅうろくねん」と書けば通りそうですが、そこまでは試していません。年号を入れる台本は、いまは避けるのが無難です。
日本語でつまずくのは朗読だけではありません。歌詞のほうで漢字を誤読された話はSunoで日本語の歌詞がうまく歌えない時の対処法にまとめています。
そして途中で訛りが変わります。日本語を話す外国人のような喋り方になる瞬間があって、中国語か韓国語を母語にしている人の日本語に近い。Suno公式はベータ版の弱点として訛りが途中で変わることを認めていますが、日本語だとこういう形で出ます。「静かな水面にうかぶ三日月」のあたりも読みにくそうでした。
英語版と比べると、崩れ方が逆です。英語版は曲名の切れ目を間違えたものの、最後まで訛りは一定でした。日本語版は曲名を正しく区切ったのに、途中で喋り方が変わる。どちらがマシかではなく、転ぶ場所が違います。
BGMを切ったら、ブレス音が前に出てきた
同じ台本でBGMだけ外しました。83.08秒。BGMありが83.12秒なので、差は0.04秒しかありません。
音は別物でした。エコーがかかったように聞こえて、息を吸う音が強く残る。イヤホンでなくても、MacBookのスピーカーで分かるくらいはっきり出ます。読み上げツールとして使えるかと自問して、微妙という答えになりました。BGMが粗さを隠していた、ということだと思います。
それと0.04秒という数字が引っかかります。別々に作った2本なのに、語りの尺がここまで揃う。公式は声と音楽を1つのトラックとして生成する初のモデルだと言っていますが、なぜ揃うのかは分かりません。語りを先に作ってBGMを後から乗せているのでは、というのは素人の勘で、根拠はこの0.04秒だけです。
口調の欄は効く。BGMのムードまで一緒に変わる
口調の欄に明るいCM風の指示を入れた1本で、いちばん使える結果が出ました。72.0秒。狙いどおり明るくなり、しかも読みだけでなくBGMまで明るくなりました。
Sunoの画面にBGMのムードを指定する欄はありません。口調の欄がそこも兼ねている、と考えて書けばいい。
ただし同じ指示を入れても同じ声は返ってきません。入力したのは一文なのに、出来上がった2本に付いていた説明文は別物に膨らんでいました。しかも正反対で、片方は低い声で抑揚なし、もう片方は細い声で明るい。
長さは1分12秒と32秒。倍以上違います。短いほうを聞いてみたら、台本の途中で終わっていました。「そのまま、ありのまま受け入れる」まで読んで、残りの3行を読まずに切れている。
エラーは出ません。見た目は普通に完成した1本です。聞かないと気づけない。1回の生成で2本できるので、2本とも最後まで聞いて、台本を読みきっているほうを採ることになります。
なお設定メニューの「言語」は画面の表示を切り替えるだけです。喋る言語は台本に書いた言語で決まります。
1分20秒を境に、声がBGMに沈み始める。張り出しが12デシベルから2.5デシベルへ
ここまでは1分台の台本です。長いとどうなるかを見るために、4分台のものを2本作りました。
1本目は、同じ台本を3回続けて貼ったもの。4分10秒。後半になるほど雑音が乗って、声も聞き取りづらくなりました。
ただしこれでは、長さのせいなのか同じ文章を繰り返したせいなのか分かりません。そこで2本目は、最初から最後まで中身の違う4分台の台本を書いて入れました。読めないと分かっている西暦と造語は、原因を混ぜないためにわざと抜いています。出来上がりは4分24秒。
結果は割れました。雑音は出ません。 これは繰り返しが原因でした。
聞き取りづらさのほうは、そのまま残りました。 最初の30秒と最後の30秒では別物です。終盤は何を言っているのか分からない。BGMの大きさは変わっていないように聞こえるのに、声だけが遠ざかっていきます。
耳の印象を数字にしてみた
ここはClaude Codeに測ってもらいました。音声ファイルの波形から音量を計算できるそうです。
最初に出てきた数字は、意外なものでした。全体の音量は最初も最後もほとんど変わらない。差は0.2デシベルで、人間には聞き分けられない差です。
理由を聞いたら、BGMごと平均していたからでした。BGMは鳴り続けているので、声が小さくなっても全体の数字は動かない。そこで測り方を変えてもらいました。BGMを「床」として、そこから声がどれだけ飛び出しているかを測る方法です。この数字が大きいほど、声がはっきり前に出ています。
4分24秒のほうを20秒ごとに並べると、こうなりました。
| 経過時間 | 声の張り出し |
|---|---|
| 0〜20秒 | 12.0デシベル |
| 40〜60秒 | 13.4デシベル |
| 1分20秒〜1分40秒 | 5.5デシベル |
| 2分〜2分20秒 | 5.7デシベル |
| 3分〜3分20秒 | 4.0デシベル |
| 4分〜4分20秒 | 2.5デシベル |
1分20秒あたりまでは保っています。そこから崩れます。 最後は2.5デシベルで、BGMとほとんど同じ高さまで沈んでいました。
1分台の音声でも、同じことが起きていた
ついでに短いほうも全部測ってもらったら、どれも下がっていました。
| 音声 | 最初の20秒 | 最後の20秒 |
|---|---|---|
| 英語・1分08秒 | 10.7 | 8.1 |
| 日本語・1分23秒 | 10.6 | 5.5 |
| 日本語CM風・1分12秒 | 8.2 | 7.1 |
| 日本語・4分24秒 | 12.0 | 2.5 |
4本とも下がっています。長い台本だけの問題ではなく、どの音声でも声は最初から沈み続けている。 1分台なら下がりきる前に終わるので気づかないだけでした。
長い台本も通ること自体は確認できました。ただし長いほど終盤が犠牲になります。台本は1分台で区切って何本かに分け、動画編集側でつなぐ。いまはそれが現実的です。
値段は曲とまったく同じ。1回10クレジットで2本
1分台の4本を作ったときは、4回生成して8本できて、消費は40クレジットでした。1回の生成が10クレジットで2本。Sunoの通常の曲生成も10クレジットで2曲なので、Speechは曲を1曲作るのと同じ値段です。
朗読1本のつもりが、曲1本ぶん減ります。
いま自分が何クレジット使えるのか分からない人は、Sunoの料金プラン解説を先に見ておくといいと思います。
日本語はBGMあり前提の語りにだけ使う
日本語は、BGMありの前提でなら使います。世界観の語りや予告のような、多少の訛りが雰囲気として成立する用途です。逆に、製品説明のように内容を正確に伝えたい場面は向きません。訛りが切り替わる瞬間が耳に残って、聞き手の意識が内容から離れます。
ここで作った音声を動画に載せる工程は、リリックビデオの字幕タイミングをClaude Codeに任せた4段階に書きました。
「AIで作った曲や制作の記録」を発信する場所として、ブログもおすすめです。私が実際にブログを開設した手順はこちらにまとめています。
コメント